Лекция №8. Введение в «Объектно – Ориентированное Программирование».
Классы и объекты являются основными концепциями объектно – ориентированного программирования — ООП.
Объектно – ориентированное программирование (ООП)
— расширение структурного программирования, в котором основными концепциями являются понятия классов и объектов.
Основное отличие языка программирования С++ от С состоит в том, что в языке программирования С нет классов, а, следовательно, язык С не поддерживает ООП, в отличие от С++.
§8.1 Определение объекта
Объект в контексте ООП
— это достаточно общее и широкое понятие, которое может иметь различные трактовки. В широком смысле объект представляет собой любую сущность, имеющую определенный набор свойств (параметров, характеристик) и обладающую некоторым поведением (функциональностью).
Объектом может быть практически все, что угодно: материальные предметы (компьютер, автомобиль, человек), логические понятия (файл, документ, таблица, список) или математические абстракции (отрезок, окружность).
Таким образом, объект характеризуется двумя фундаментальными аспектами: состоянием (свойствами) и поведением.
При рассмотрении объекта «Человек» приходит осознание того, что человек может быть как студент учебного заведения, как сотрудник организации, как пациент больницы и так далее. Строить всеобъемлющий объект «на все случаи жизни» не имеет смысла, поскольку это будет очень большой объект. Поэтому один из важнейших принципов построения моделей – это принцип абстрагирования, т.е. выделение наиболее существенных для решаемой задачи черт исходного объекта и отбрасывание второстепенных деталей.
Достоинством объектных программ является их четкая структуризация – каждый объект выполняет свою строго определенную задачу, а их совместная работа позволяет достичь поставленных целей.
Программный объект
– это условное понятие, с которым связывается набор некоторых данных и программный код обработки этих данных: объект: данные + программный код
Главное преимущество ООП заключается в инкапсуляции — объединении данных и методов работы с ними в одном объекте. Благодаря этому объект становится законченной программной единицей, которую можно передавать целиком, сохраняя как данные, так и функциональность.
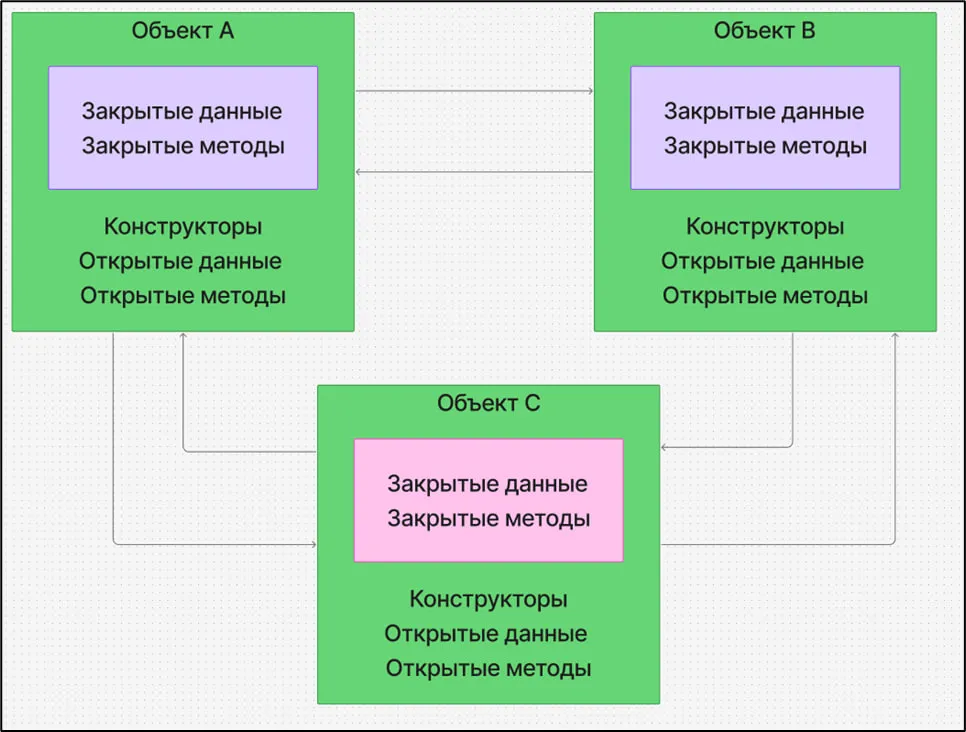
При этом каждый объект проходит определенный жизненный цикл:
- Объект создается методом-конструктором.
- Объект используется другими объектами, предоставляя им свои открытые методы и неявно – закрытые данные.
- Объект уничтожается (явно деструктором или неявно механизмом сборки мусора).
§8.2 Определение классов
Класс
- формализованный способ описания однотипных объектов, т.е. объектов с одинаковым набором свойств и методов.
Именно при описании класса перечисляются свойства и реализуются методы соответствующих объектов. Разработка объектной программы начинается с описания необходимых классов.
На основе одного класса можно создать любое разумное (все ресурсы вычислительной системы конечны!) число объектов, называемых экземплярами этого класса.
Все используемые в программе объекты должны быть экземплярами некоторых классов, стандартных или собственных. Соответствие между понятиями «объект» и «класс» аналогично соответствию между понятиями «переменная» и «тип данных».
Правила описания классов различны для разных языков, тем не менее можно отметить ряд общих моментов. Описание класса включает в себя:
- Заголовок класса, включающий специальную директиву class и имя класса. Практически всегда в заголовке класса задается дополнительная информация о классе.
- Тело класса, содержащее перечень свойств (полей данных), заголовки методов и их программную реализацию (не всегда).
В классах допускается объявлять так называемые абстрактные методы, у которых есть только заголовок (имя и параметры), но нет программной реализации.
Если класс содержит хотя бы один абстрактный метод, он сам считается абстрактным.
Важная особенность абстрактных классов состоит в том, что объекты-экземпляры на их основе создавать нельзя. Абстрактные классы используются для описания абстрактных понятий.
Общие правила описания свойств:
- Каждое свойство объявляется как обычная переменная, т.е. Для нее обязательно задается имя и тип (простейший, структурный или объектный).
- Имена всех свойств в классе должны быть различными.
- Свойства рекомендуется объявлять закрытыми с помощью специальной директивы private (такие свойства доступны для прямого использования только внутри методов данного класса). Открытые свойства (если необходимо нарушить принцип инкапсуляции) объявляются с помощью директивы public.
Общие правила описания методов:
- Метод оформляется как обычная подпрограмма, с указанием имени, формальных параметров (если необходимо) и типа возвращаемого значения.
- Допускается объявлять несколько методов с одним и тем же именем, но разными наборами формальных параметров (так называемая перегрузка методов, overloading). Наборы параметров должны отличаться либо их числом, либо типами параметров.
- Каждый метод должен быть объявлен либо как открытый (директива public), либо как закрытый (private). Закрытые методы могут использоваться только другими методами данного класса.
- Метод может быть объявлен статическим. Такой метод можно вызывать без создания объектов.
- Методы доступа для чтения значений закрытых свойств (get-методы) рекомендуется именовать с префиксом get (например, GetColor, GetSize) и оформлять как функцию без параметров, возвращающую тип соответствующего свойства.
- Методы доступа для изменения значений закрытых свойств (set-методы) рекомендуется именовать с префиксом set (например, SetColor, SetSize) и оформлять как процедуру (void-функцию) с одним входным параметром.
В ООП существует три основных принципа построения классов:
- Инкапсуляция — это свойство, позволяющее объединить в классе и данные, и методы, работающие с ними и скрыть детали реализации от пользователя.
- Наследование — это свойство, позволяющее создать новый класс-потомок на основе уже существующего, при этом все характеристики класса родителя присваиваются классу-потомку.
- Полиморфизм — свойство классов, позволяющее использовать объекты классов с одинаковым интерфейсом без информации о типе и внутренней структуре объекта.
§8.3 Классы в С++
Класс в C++
— это пользовательский тип данных, который объединяет поля (данные) и методы (функции) для работы с этими данными. Объявляется с помощью ключевого слова class, а объекты создаются как экземпляры этого класса.
§8.3.1 Объявление классов в С++
В языке C++ класс является фундаментальным механизмом реализации объектно-ориентированного программирования. Класс представляет собой пользовательский тип данных, который объединяет данные (поля или атрибуты) и функции (методы), оперирующие этими данными, в единую структуру. Таким образом, класс служит шаблоном (или чертежом) для создания объектов — конкретных экземпляров данного типа.
Объявление класса в C++ осуществляется с использованием ключевого слова class, за которым следует имя класса, далее — блок, заключённый в фигурные скобки, содержащий объявления полей и методов. Завершается объявление точки с запятой. Синтаксис имеет следующий вид:
cpp
class Person
{
   //модификатор_доступа:

   //набор свойств

   //набор методов
};
По умолчанию все члены класса, объявленные без указания модификатора доступа, имеют уровень доступа private, то есть доступ к ним ограничен самим классом и его дружественными функциями. Это обеспечивает инкапсуляцию — один из ключевых принципов ООП, предполагающий сокрытие внутренней реализации от внешнего воздействия.
Поля класса (или члены-данные) представляют собой переменные, которые хранят состояние объекта. Методы (или члены-функции) определяют поведение объекта — действия, которые он может выполнять. Методы могут быть объявлены непосредственно внутри класса (в этом случае они по умолчанию являются встроенными — inline) или объявлены внутри класса, а определены вне его с использованием оператора разрешения области видимости ::.
Например, рассмотрим объявление простого класса Point, представляющего точку на плоскости:
cpp
class Point {
    private:
        double x;
        double y;

    public:
        void setX(double value);
        void setY(double value);
        double getX() const;
        double getY() const;
};
Здесь поля x и y объявлены как private, что исключает прямой доступ к ним извне. Доступ к ним предоставляется через публичные методы setX, setY, getX, getY, что позволяет контролировать корректность присваиваемых значений и обеспечивает целостность данных.
Определение методов, объявленных в классе, может быть вынесено за пределы объявления класса:
cpp
void Point::setX(double value) {
    x = value;
}

double Point::getX() const {
    return x;
}
Ключевое слово const в объявлении метода getX() указывает, что данный метод не изменяет состояние объекта, что позволяет вызывать его на константных экземплярах класса.
Переменная класса называется экземпляром (или «объектом») класса. Точно так же, как определение переменной фундаментального типа данных (например, int x) приводит к выделению памяти для этой переменной, так же и создание объекта класса (например, Person person) приводит к выделению памяти для этого объекта. Класс можно представлять себе, как нечто вроде типа данных более высокого уровня.
После объявления класса можно создавать его экземпляры — объекты, которые представляют конкретные данные и обладают определённым поведением. Например, для класса Point, моделирующего точку на плоскости, можно объявить один или несколько объектов в функции main:
cpp
int main() {
    Point p;
}
Здесь переменная p является объектом класса Poin. Через этот объект осуществляется доступ к полям и методам класса с использованием оператора выбора членов — точки (.).
Если класс содержит публичные поля (что на практике используется редко из соображений инкапсуляции), к ним можно обращаться напрямую. Однако в правильно спроектированном классе доступ к данным осуществляется через публичные методы.
Например, предположим, что в классе Point методы setX, setY, getX и getY объявлены как public. Тогда в функции main можно инициализировать координаты точки и получать их следующим образом:
cpp
int main() {
    Point p;

    // вызов метода для установки значения x
    p.setX(3.5);

    // вызов метода для установки значения y
    p.setY(2.0);

    double x = p.getX(); // получение значения x
    double y = p.getY(); // получение значения y

    std::cout << "Точка: (" << x << ", " << y << ")";

    return 0;
}
Оператор точки (.) связывает объект с конкретным членом класса — будь то поле или метод. При этом вызов p.getX() означает: «вызвать метод getX для объекта p».
§8.3.2 get / set – методы
В объектно-ориентированном программировании на C++ прямой доступ к полям класса извне ограничивается с целью обеспечения инкапсуляции. Инкапсуляция предполагает сокрытие внутреннего представления данных класса и предоставление контролируемого интерфейса для их чтения и изменения.
Для этих целей используются специальные методы, известные как get-методы (или геттеры) и set-методы (или сеттеры).
Назначение get / set – методов:
- Get-методы предназначены для получения значения приватного поля класса.
- Set-методы позволяют устанавливать или изменять значение поля с возможностью проверки корректности передаваемых данных.
В C++ для обеспечения инкапсуляции прямой доступ к полям класса, как правило, запрещён — поля объявляются с модификатором private.
Вместо этого для чтения и изменения значений используются специальные методы: get-методы (геттеры) и set-методы (сеттеры), размещаемые в public-секции класса.
Геттеры предназначены для возврата значения (того же типа данных, что и значение Сеттера) приватного поля. Они не изменяют состояние объекта и поэтому должны объявляться как константные — с ключевым словом const после списка параметров.
Это позволяет вызывать их на константных объектах. Например, в классе Point:
cpp
class Point {
private:
    double x, y;
public:
    double getX() const;
    void setX(double value);
};
Реализация методов может выглядеть так:
cpp
double Point::getX() const { return x; }
void Point::setX(double value) { x = value; }
Сеттеры позволяют устанавливать новые значения полей. Их главное преимущество — возможность проверки корректности данных. Например:
cpp
void setAge(int age) {
    if (age >= 0 && age <= 150)
      this->age = age;
    else
      std::cerr << "Ошибка: некорректный возраст!";
}
Имена методов традиционно формируются по шаблону getИмя() и setИмя(), что делает интерфейс интуитивно понятным. Использование get/set-методов обеспечивает контроль над состоянием объекта, поддерживает инкапсуляцию и повышает надёжность кода.
§8.3.3 Модификаторы доступа
Модификаторы доступа
— это ключевые элементы системы инкапсуляции в объектно-ориентированном программировании, определяющие, какие члены класса (поля, методы, свойства) доступны извне, а какие остаются скрытыми. Они управляют видимостью компонентов класса и обеспечивают контроль над взаимодействием между объектами и внешним кодом.
В языках C++ и C# набор модификаторов доступа, а также их назначение, существенно совпадают, что отражает общую объектно-ориентированную парадигму и способствует лёгкому переходу между этими языками.
В C++ используются следующие основные модификаторы доступа:
- private — члены класса доступны только внутри самого класса и его дружественных функций или классов.
- protected — члены доступны внутри класса и в производных классах, но не доступны извне.
- public — члены доступны из любого места программы, где виден объект класса.
По умолчанию все члены класса в C++ являются private, если явно не указан иной модификатор.\
cpp
class Point {
private:
    double x, y;  // доступны только внутри класса

protected:
    void normalize();  // доступен в наследниках

public:
    Point(double x, double y);
    double getX() const;  // открытый интерфейс
};
В C# модификаторы доступа семантически аналогичны:
- private — доступ только внутри объявляющего класса.
- protected — доступ внутри класса и его наследников.
- public — полный доступ извне.
Отличие в том, что в C# по умолчанию члены класса имеют уровень доступа private, как и в C++. Однако C# предоставляет дополнительные модификаторы, такие как internal и protected internal, которые учитывают сборки (assemblies), но базовые принципы остаются теми же.
csharp
class Person
{
    private string name; // доступ только внутри класса

    protected int age;    // доступ в наследниках

    public string Name    // открытое свойство
    {
        get { return name; }
        set { name = value; }
    }
}
Открытые члены классов составляют интерфейс класса. Поскольку доступ к открытым членам класса может осуществляться извне класса, то открытый интерфейс и определяет, как программы, использующие класс, будут взаимодействовать с этим же классом. Если модификатор доступа явно необъявлен, то класс по умолчанию устанавливает всем своим членам спецификатор доступа private. Структура же по умолчанию устанавливает всем своим членам спецификатор доступа public.
§8.4 Классы в С#
Класс в C#
— это ссылочный тип, определяющий шаблон для создания объектов, который может содержать поля, свойства, методы, события и конструкторы. Объявление класса осуществляется с помощью ключевого слова class, за которым следует имя типа и блок в фигурных скобках, включающий его члены.
§8.4.1 Объявление классов в С#
В языке C# класс является фундаментальной единицей объектно-ориентированного программирования и представляет собой ссылочный тип, определяющий шаблон для создания объектов. Класс объединяет данные (поля, свойства) и поведение (методы, события, конструкторы) в единую структуру, обеспечивая инкапсуляцию, наследование и полиморфизм — ключевые принципы ООП.
Объявление класса в C# начинается с ключевого слова class, за которым следует имя класса, и блока в фигурных скобках, содержащего его члены. Синтаксис имеет следующий вид:
text
class имя_класса
{
   уровень_доступа тип переменная1;
   уровень_доступа тип переменная2;

   уровень_доступа тип_возвращаемого_значения метод1(параметры) {
      //тело метода
   }

   уровень_доступа тип_возвращаемого_значения метод2(параметры) {
      //тело метода
    }
}
Класс можно определять внутри пространства имен, вне пространства имен, внутри другого класса. Как правило, классы помещаются в отдельные файлы. Но в данном случае поместим новый класс в файле, где располагается класс Program. То есть файл Program.cs будет выглядеть следующим образом:
csharp
using System;
namespace HelloApp
{
   class Person
   {
      // реализация класса Person
   }

   class Program
   {
      static void Main(string[] args)
      {
          // реализация main
      }
   }
}
Вся функциональность класса представлена его членами:
- Полями (полями называются переменные класса).
- Свойствами (поля с методами доступа).
- Методами.
- Событиями.
Поля
— это переменные, хранящие состояние объекта.
Они могут быть любого допустимого типа, включая встроенные (например, int, double, bool) и пользовательские. По умолчанию поля имеют модификатор доступа private, если явно не указан другой. Указывать модификатор public не рекомендуется из – за принципа инкапсуляции.
csharp
class Person
{
    private string name;
    private int age;
}
Прямой доступ к private-полям извне класса запрещён, что обеспечивает инкапсуляцию. Для контролируемого доступа к полям в C# вместо традиционных get/set-методов, как в C++, используются свойства.
§8.4.2 Свойства
Кроме обычных методов в языке C# предусмотрены специальные методы доступа, которые называют свойства. Они обеспечивают контролируемый доступ к полям классов и структур, узнать их значение или выполнить их установку.
Стандартное описание свойства имеет следующий синтаксис:
text
[модификатор_доступа] возвращаемый_тип произвольное_название
{
   // код свойства
}
Синтаксически свойство объявляется как элемент класса с указанием типа, имени и блока, содержащего один или два аксессора — get и set. Аксессор get определяет, какое значение возвращается при чтении свойства, а set — как обрабатывается присваиваемое значение. Внутри set используется специальное ключевое слово value, обозначающее переданное значение.
csharp
private string name;

public string Name
{
    get { return name; }
    set { name = value; }
}
Такое объявление позволяет читать и изменять значение name через person.Name, при этом обеспечивая полный контроль над операциями. Например, в аксессоре set можно добавить проверку корректности:
csharp
set
{
    if (!string.IsNullOrEmpty(value))
        name = value;
    else
        throw new ArgumentException("Ошибка.");
}
В современном C# часто используются автосвойства (auto-implemented properties) — упрощённая форма записи, при которой компилятор автоматически создаёт скрытое резервное поле. Это особенно удобно, когда аксессоры не требуют дополнительной логики.
csharp
public string Name { get; set; }
public int Age { get; set; }
Несмотря на отсутствие явного поля, компилятор генерирует его за кадром, обеспечивая стандартное поведение. Автосвойства уменьшают объём кода и повышают его читаемость, оставаясь полностью совместимыми с обычными свойствами.
Свойство может быть доступно только для чтения — если в нём отсутствует аксессор set. Такие свойства инициализируются либо в конструкторе, либо с помощью инициализатора.
csharp
public string Id { get; private set; }
Здесь set объявлен как private, что позволяет изменять значение только внутри класса, но не извне. Это часто используется для идентификаторов или других неизменяемых атрибутов.
С C# 6.0 появилась возможность задавать начальное значение автосвойствам прямо при объявлении:
csharp
public DateTime CreatedAt { get; set; } = DateTime.Now;
public string Status { get; set; } = "Active";
Аксессоры могут иметь разные уровни доступа. Например:
csharp
public List<string> Items { get; private set; } = new List<string>();
Здесь set — private, что позволяет внешнему коду только читать список, но не заменять его, при этом сам класс может управлять им. Это часто используется для коллекций, чтобы предотвратить их несанкционированную подмену.
При использовании модификаторов в свойствах следует учитывать ряд ограничений:
- Модификатор для блока set или get можно установить, если свойство имеет оба блока (и set, и get).
- Только один блок set или get может иметь модификатор доступа, но не оба сразу.
- Модификатор доступа блока set или get должен быть более ограничивающим, чем модификатор доступа свойства. Например, если свойство имеет модификатор public, то блок set/get может иметь только модификаторы internal, protected, private.
§8.5 Конструкторы и инициализация объектов
Конструктор
— это специальный метод класса, предназначенный для инициализации состояния объекта в момент его создания. Он обеспечивает корректную настройку полей, выполнение предварительных проверок и подготовку объекта к использованию.
Отсутствие явной инициализации может привести к неопределённому поведению, особенно в случае использования неинициализированных переменных.
Языки C++ и C#, несмотря на различия в управлении памятью и системе типов, предоставляют мощные и гибкие механизмы конструирования объектов, основанные на общей объектно-ориентированной парадигме.
В C++ конструктор вызывается автоматически при создании объекта и имеет то же имя, что и класс. Если конструктор не объявлен, компилятор автоматически генерирует конструктор по умолчанию — без параметров, выполняющий тривиальную инициализацию.
cpp
class Point {
    double x, y;
public:
    Point() {
        x = 0.0;
        y = 0.0;
    }
};
Однако, если программист определяет хотя бы один конструктор, автоматическая генерация конструктора по умолчанию отменяется. Это требует явного объявления, если он необходим.
Конструкторы могут быть перегружены
— класс может иметь несколько конструкторов с разными параметрами.
Пример создания перегрузки конструкторов показан ниже.
cpp
Point() {
   x = 0.0;
   y = 0.0;
}

Point(double x, double y) {
   this->x = x;
   this->y = y;
}
В отличие от обычных методов, конструкторы имеют определенные правила по поводу их имен:
- Конструкторы всегда должны иметь то же имя, что и класс (учитываются верхний и нижний регистры).
- Конструкторы не имеют типа возврата (даже void).
Если в классе определены конструкторы, то при создании объекта этого класса необходимо вызвать один из его конструкторов. Вызов конструктора получает значения для параметров и возвращает объект класса:
cpp
Point point = Point(12, 22);
Для инициализации членов класса также можно использовать списки инициализации. Список инициализации характеризуется двоеточием (:) с последующим объявлением параметров, содержащихся в круглых скобках (…), индивидуальными переменными-членами и значениями для инициализации.
cpp
Person() : name(n), age(a) {}
В C# все объекты создаются в управляемой куче с помощью оператора new, а сборщик мусора отвечает за их освобождение. Конструктор в C# также совпадает по имени с классом, не имеет возвращаемого типа и вызывается при создании экземпляра.
csharp
class Person
{
    public string Name { get; set; }
    public int Age { get; set; }

    public Person()
    {
        Name = "Неизвестный";
        Age = 0;
    }
}
Если конструкторы не объявлены, компилятор C# автоматически генерирует конструктор по умолчанию, который инициализирует все поля значениями по умолчанию (например, 0 для чисел, null для ссылочных типов). В отличие от C++, этот конструктор сохраняется, пока не объявлен хотя бы один пользовательский конструктор.
Перегрузка конструкторов в C# работает аналогично C++:
csharp
class Person
{
    public string Name { get; set; }
    public int Age { get; set; }

    public Person()
    {
        Name = "Неизвестный";
        Age = 0;
    }

    public Person(string name, int age)
    {
       Name = name;
       Age = age;
    }
}
В C++ самая простая инициализация происходит с помощью вызова конструктора: Point p = new Point(12,23).
В C# для упрощения инициализации используются инициализаторы объектов — конструкция, позволяющая задавать значения свойств сразу после вызова конструктора:
csharp
Person person = new Person()
{
    Name = "Мария",
    Age = 25
};

// это эквивалентно
Person person = new Person();
person.Name = "Мария";
person.Age = 25;
Но выглядит лаконичнее и читается как декларативное описание состояния объекта. Инициализаторы особенно удобны при работе с коллекциями и настройке сложных объектов.
§8.6 Деструкторы
Деструктор
— это специальный метод, который вызывается при уничтожении объекта.
Его задача — выполнить завершающие действия: освободить ресурсы, вывести сообщение, сбросить данные или просто «попрощаться» с объектом.
Однако в C++ и C# деструкторы работают по-разному, и это связано с тем, как каждый язык управляет памятью.
В C++ объекты могут создаваться в стеке или в динамической памяти. Когда объект перестаёт существовать (например, завершается блок, в котором он объявлен), его деструктор вызывается автоматически и сразу. Это делает поведение деструктора предсказуемым.
Деструктор записывается с символом ~ перед именем класса, не имеет параметров и не возвращает значение.
cpp
class Counter {
public:
    Counter() {
        std::cout << "Объект создан\n";
    }

    ~Counter() {
        std::cout << "Объект уничтожен\n";
    }
};

int main() {
    {
        Counter c;  // вызывается конструктор
    } // здесь заканчивается блок → вызывается деструктор

    return 0;
}
Вывод программы:
wireframe
Объект создан

Объект уничтожен
Видно, что деструктор вызывается точно в нужный момент — при выходе из блока. Это позволяет использовать деструкторы для автоматического освобождения ресурсов, например, закрытия соединений или удаления выделенной памяти.
Важно запомнить следующее:
- Конструктор и деструктор, мы всегда объявляем в разделе public.
- При объявлении конструктора, тип данных возвращаемого значения не указывается.
- У деструктора также нет типа данных для возвращаемого значения, к тому же деструктору нельзя передавать никаких параметров.
- Имя класса и конструктора должно быть идентично.
- Имя деструктора идентично имени конструктора, но с приставкой ~ .
- В классе допустимо создавать несколько конструкторов, если это необходимо. Имена, согласно пункту 2 нашего списка, будут одинаковыми. Компилятор будет их различать по передаваемым параметрам (как при перегрузке функций). Если мы не передаем в конструктор параметры, он считается конструктором по умолчанию.
- Обратите внимание на то, что в классе может быть объявлен только один деструктор.
Деструктор автоматически вызывается, когда удаляется объект. Удаление объекта происходит в следующих случаях:
- Когда завершается выполнение области видимости, внутри которой определены объекты.
- Когда удаляется контейнер (например, массив), который содержит объекты.
- Когда удаляется объект, в котором определены переменные, представляющие другие объекты.
- Динамически созданные объекты удаляются при применении к указателю на объект оператора delete.
В C# всё иначе. Объекты создаются в управляемой памяти, и за их удаление отвечает сборщик мусора — специальная подсистема, которая сама решает, когда удалять «мертвые» объекты. Поэтому деструктор в C# (его ещё называют финализатор) вызывается не сразу, а когда захочет сборщик мусора — это может быть через секунду, минуту или вообще никогда за время работы программы.
Финализатор в C# объявляется так:
csharp
class Counter
{
    public Counter()
    {
        Console.WriteLine("Объект создан");
    }

    ~Counter()  // финализатор
    {
        Console.WriteLine("Объект уничтожен");
    }
}
// Если создать объект:
static void Main()
{
    Counter c = new Counter();

    c = null; // объект больше не используется, но деструктор НЕ вызывается сразу!
}
Сообщение «Объект уничтожен» может появиться много позже — или не появиться вовсе, если сборщик мусора не успел сработать. Поэтому нельзя полагаться на финализатор для важных действий, например, для закрытия файла или сохранения данных.
Для надёжного освобождения ресурсов в C# используется интерфейс IDisposable. Класс может реализовать метод Dispose(), который нужно вызывать вручную или с помощью конструкции using.\
csharp
class Counter : IDisposable
{
    public Counter()
    {
        Console.WriteLine("Объект создан");
    }

    public void Dispose()
    {
        Console.WriteLine("Ресурсы освобождены");
    }
}
Использование данного класса необходимо производить с ключевым словом using, чтобы как только работа с объектом закончилась, вызывался метод Dispose():
csharp
static void Main()
{
    using (Counter c = new Counter())
    {
        // работа с объектом
    } // здесь автоматически вызывается Dispose()
}
Теперь сообщение «Ресурсы освобождены» появится сразу, как только блок using закончится — даже если произойдёт ошибка.
§8.7 Типы значений и ссылочные типы значений в С#
Одной из ключевых особенностей языка C# является чёткое разделение типов данных на значимые типы (value types) и ссылочные типы (reference types). Это различие определяет, как данные хранятся в памяти, как передаются между методами и как ведут себя при присваивании. Понимание этой разницы необходимо для правильного проектирования программ и предотвращения неожиданного поведения.
Типы значений хранят сами данные непосредственно в переменной. К ним относятся:
- Все встроенные числовые типы (int, double, bool, char и т.д.).
- Структуры (struct).
- Перечисления (enum).
Когда переменная типа значения присваивается другой переменной, копируется само значение:
csharp
int a = 10;
int b = a;

b = 20;

Console.WriteLine(a); // Вывод: 10
Здесь a и b — независимые переменные. Изменение b не влияет на a. Это поведение аналогично работе с обычными числами в математике.
Типы значений размещаются, как правило, в стеке (если это локальные переменные), что делает их использование быстрым и эффективным.
Ссылочные типы работают иначе. Переменная ссылочного типа хранит не само значение, а ссылку (указатель) на объект, расположенный в управляемой куче (heap). К ссылочным типам относятся:
- Классы (class).
- Массивы.
- Делегаты.
- Строки (string).
csharp
Person p1 = new Person("Анна");

Person p2 = p1;

p2.Name = "Мария";

Console.WriteLine(p1.Name); // Вывод: Мария
Здесь p1 и p2 ссылаются на один и тот же объект в памяти. Присваивание p2 = p1 копирует ссылку, а не объект. Поэтому, когда мы меняем p2.Name, мы фактически меняем состояние объекта, на который указывает и p1, и p2.
Это важное отличие: при работе со ссылочными типами несколько переменных могут управлять одним объектом, и изменения через одну переменную будут видны через все остальные.
Рассмотрим поведение структуры (тип значения) и класса (ссылочный тип):
csharp
struct PointS  // структура — тип значения
{
    public int X, Y;
}

class PointC    // класс — ссылочный тип
{
    public int X, Y;
}

// Тип значения
PointS s1 = new PointS { X = 1 };
PointS s2 = s1;

s2.X = 10;

Console.WriteLine(s1.X); // 1 — s1 не изменился

// Ссылочный тип
PointC c1 = new PointC { X = 1 };
PointC c2 = c1;

c2.X = 10;

Console.WriteLine(c1.X); // 10 — c1 изменился!
Разница очевидна: структуры копируются полностью, классы — передаются по ссылке.
§8.8 Ключевое слово «this»
В объектно-ориентированном программировании внутри методов класса часто возникает необходимость сослаться на текущий экземпляр объекта. Для этого используется ключевое слово this — специальный ссылочный идентификатор, который в контексте экземплярного метода обозначает сам объект, у которого был вызван метод.
Оно позволяет устранять неоднозначности при именовании параметров, передавать текущий объект в качестве аргумента, возвращать его из методов и организовывать цепочки вызовов. В разных языках, таких как C++ и C#, слово this имеет схожую семантику, но реализуется с учётом особенностей каждой системы типов.
§8.8.1 Ключевое слово «this» в С++
В C++ выражение this представляет собой указатель на текущий объект. Оно имеет тип T*, где T — имя класса, и доступно только в нестатических методах. Поскольку это указатель, для доступа к членам объекта через this используется оператор ->.
cpp
class Person {
    std::string name;
public:
    void setName(const std::string& name) {
        // разрешение конфликта имён
        this->name = name;
    }

    void print() {
        std::cout << "Имя: " << this->name;
    }
};
Здесь в методе setName параметр name имеет то же имя, что и поле класса. Чтобы устранить неоднозначность, используется this->name, что явно указывает: «обращайся к полю объекта, а не к параметру». Это — одно из самых частых применений this.
Кроме того, this можно возвращать из методов, что позволяет организовывать цепочку вызовов (method chaining):
cpp
Person& setName(const std::string& name) {
    this->name = name;
    return *this;  // возвращаем разыменованный указатель
}

Person& setAge(int age) {
    this->age = age;
    return *this;
}
Теперь можно писать:
cpp
Person p;
p.setName("Анна").setAge(25);  // цепочка вызовов
В этом случае this разыменовывается с помощью *this, чтобы вернуть ссылку на объект.
§8.8.2 Ключевое слово «this» в С#
В C# выражение this является ссылкой на текущий экземпляр, а не указателем. Оно доступно только в экземплярных методах и свойствах, и используется с оператором точки (.).
csharp
class Person
{
    private string name;

    public void SetName(string name)
    {
        // поле класса = параметр метода
        this.name = name;
    }

    public void Print()
    {
        Console.WriteLine("Имя: " + this.name);
    }
}
Как и в C++, this применяется для разрешения коллизий имён, когда параметр метода называется так же, как поле класса. Без this присваивание name = name; было бы бессмысленным (присвоение параметра самому себе), а с this становится ясно: «полю name присвоить значение параметра name».
В C# this также можно возвращать для построения цепочек вызовов:
csharp
public Person SetName(string name)
{
    this.name = name;
    // возвращаем ссылку на текущий объект
    return this;
}

public Person SetAge(int age)
{
    this.age = age;
    return this;
}
Использование:
csharp
Person p = new Person();
p.SetName("Борис").SetAge(30);
Здесь this — это ссылка, и возвращать её можно напрямую, без разыменования.
Ключевое слово this в C++ и C# служит одной и той же цели — предоставить доступ к текущему объекту внутри его методов. Основное различие заключается в том, что в C++ this — это указатель, требующий явного разыменования, а в C# — ссылка, с более простым синтаксисом. Кроме того, C# расширяет возможности this, позволяя использовать его для создания расширяющих методов. Понимание этих особенностей помогает писать чистый, понятный и эффективный код в обоих языках.
§8.9 Статические члены класса
В объектно-ориентированном программировании, помимо данных и методов, относящихся к отдельным объектам, часто возникает необходимость в элементах, которые принадлежат всему классу в целом, а не конкретному экземпляру. Такие элементы называются статическими членами класса — это могут быть статические поля, методы, свойства или конструкторы. Они существуют независимо от объектов и одинаковы для всех экземпляров класса.
Языки C++ и C# поддерживают статические члены, хотя и реализуют их по-разному.
В C++ статический член объявляется с ключевым словом static внутри класса. Он не принадлежит отдельному объекту, а общий для всех экземпляров. Например, если нужно посчитать, сколько объектов класса было создано, можно использовать статическое поле:
cpp
class Counter {
private:
    // общий счётчик для всех объектов
    static int totalCount;
    int id;

public:
    Counter() {
        totalCount++;
        id = totalCount;
    }

    static int GetTotalCount() {
        return totalCount;
    }
};

// Статическое поле нужно определить вне класса
int Counter::totalCount = 0;
Здесь totalCount — одно единственное поле, которое разделяют все объекты класса Counter. При создании каждого нового объекта значение увеличивается.
Обратите внимание
Статическое поле объявляется внутри класса, но определяется один раз вне класса — это требование C++.
Доступ к статическому методу осуществляется через имя класса и оператор «::»:
cpp
cout << Counter::GetTotalCount(); // вывод: 0, 1, 2 и т.д.
Статические методы могут работать только со статическими полями и не имеют доступа к this, потому что они вызываются без создания объекта.
В C# статические члены объявляются аналогично — с помощью ключевого слова static, но не требуют отдельного определения вне класса. Это делает их использование проще и интуитивнее.
csharp
class Counter
{
    // статическое поле
    private static int totalCount = 0;
    private int id;

    public Counter()
    {
        totalCount++;
        id = totalCount;
    }

    public static int GetTotalCount()
    {
        return totalCount;
    }
}
Теперь, как и в C++, каждый новый объект увеличивает общий счётчик. Но в C# нет необходимости «дописывать» поле вне класса — компилятор всё делает сам.
Вызов статического метода:
csharp
Console.WriteLine(Counter.GetTotalCount()); // через имя класса
Обратите внимание
Cтатические методы не могут обращаться к нестатическим полям напрямую, потому что те относятся к конкретным объектам, а статический метод — к классу в целом.
Представим, что у нас есть класс Person, и мы хотим, чтобы все люди знали, сколько их всего создано:
Person p1, p2, p3;

cout << "Всего людей: " << Person::GetTotalCount(); // 3
В обоих случаях результат один — статическое поле ведёт общий счёт.
C# поддерживает статический конструктор — метод, который выполняется один раз при первом обращении к классу. Он используется для инициализации статических полей:
csharp
static Counter()
{
    totalCount = 0;
    Console.WriteLine("Счётчик сброшен.");
}
В C++ такого механизма нет — инициализация статических полей выполняется вручную (как int Counter::totalCount = 0;), и программист сам отвечает за её корректность.
§8.10 Перегрузка операторов
В программировании операторы — такие как +, -, ==, [] — изначально определены для встроенных типов данных (например, int, double).
Однако при работе с пользовательскими типами, такими как классы, возникает потребность в том, чтобы эти операторы работали и с объектами. Для этого используется перегрузка операторов — механизм, позволяющий определить собственное поведение стандартных операторов для классов и структур.
Перегрузка операторов делает код более интуитивным и выразительным. Например, вместо вызова метода Add(p1, p2) можно просто написать p1 + p2, если оператор + переопределён для класса Point.
Хотя идея перегрузки схожа в C++ и C#, реализации различаются.
В C++ перегрузка операторов реализована гибко и широко: операторы можно перегружать как методы класса или как внешние функции (включая дружественные), что позволяет, например, корректно обрабатывать операции, где левый операнд — не объект класса.
В C# перегрузка операторов также поддерживается, но с более строгими ограничениями: все перегруженные операторы должны быть статическими методами внутри класса, а не внешними функциями.
Кроме того, в C# нельзя перегружать произвольные операторы — только те, что разрешены языком, и при перегрузке парных операторов (например, == и !=) требуется переопределять их оба.
§8.10.1 Перегрузка операторов в С++
В C++ можно сделать так, чтобы обычные операторы, такие как +, -, ==, работали с объектами классов, как будто это обычные числа.
Перегрузка операторов должна подчиняться принципу интуитивной ясности: поведение переопределённого оператора должно соответствовать ожиданиям программиста. Например, оператор + должен складывать, а не вычитать, а == должен проверять равенство, а не модифицировать объекты. Нарушение этих ожиданий ведёт к путанице и ошибкам.
Например, если у нас есть класс Point, представляющий точку на плоскости, мы можем написать:
cpp
Point p1(1, 2);
Point p2(3, 4);

Point p3 = p1 + p2;  // Складываем точки!
Такой код будет работать, если мы перегрузим оператор +. Это и называется перегрузкой операторов — мы сами определяем, что значит «сложить» два объекта.
В C++ можно перегружать многие, но не все операторы. Вот основные, которые разрешено переопределять:
- Арифметические: +, -, *, /, %.
- Операторы присваивания: =, +=, -=, и т.д.
- Инкремент и декремент: ++, --.
- Сравнение: ==, !=, <, >, <=, >=.
- Доступ: [], (), ->.
Но есть операторы, которые нельзя перегружать:
- . — точка (выбор члена).
- :: — оператор области видимости.
- ?: — тернарный оператор.
- sizeof — размер типа.
- .* — доступ через указатель на член.
Эти операторы слишком важны для языка, и их поведение должно быть строго фиксированным.
Пусть у нас есть класс Point:
cpp
class Point {
    int x, y;
public:
    Point(int x = 0, int y = 0) : x(x), y(y) {}

    // Перегрузка оператора + как метод класса
    Point operator+(const Point& other) const {
        return Point(x + other.x, y + other.y);
    }

    void print() const {
        std::cout << "(" << x << ", " << y << ")\n";
    }
};
Теперь можно складывать точки:
cpp
Point a(1, 2);
Point b(3, 4);

Point c = a + b;

c.print(); // Вывод: (4, 6)
Здесь operator+ — это обычный метод, который принимает один параметр (other), потому что левый операнд (a) — это this. Метод помечен как const, потому что он не меняет объект.
А что, если мы хотим написать 5 + p, где p — объект Point? Тогда оператор + не может быть методом класса, потому что 5 — это int, и он не может вызывать метод Point. В таком случае оператор нужно определить как внешнюю функцию:
cpp
Point operator+(int value, const Point& p) {
    return Point(value + p.x, p.y);
}
Теперь можно:
cpp
Point p = 10 + Point(5, 3); // p = (15, 3)
Если такой оператор должен обращаться к private-полям, его можно объявить как friend (то есть сделать оператор дружственным, который может обращаться как к публичным полям, так и приватным). Пример показан ниже.
cpp
class Point {
    int x, y;
public:
 friend Point operator+(int value, const Point& p);

 // ...
};

Point operator+(int value, const Point& p) {
    // доступ к p.x — OK, потому что friend
    return Point(value + p.x, p.y);
}
Оператор присваивания тоже может быть перегружен. По умолчанию C++ создаёт его автоматически, но если в классе есть указатели или динамическая память, его нужно определять вручную.
cpp
Point& operator=(const Point& other) {
    // защита от самоприсваивания
    if (this == &other) return *this;
    x = other.x;
    y = other.y;
    return *this; // позволяет писать a = b = c;
}
Оператор ++ бывает двух видов: ++p (префикс) и p++ (постфикс). Чтобы их различить, в постфиксной версии добавляют фиктивный параметр int:
cpp
// Префикс: ++p
Point& operator++() {
    x++;
    y++;

    return *this;
}

// Постфикс: p++
Point operator++(int) {
    // запоминаем старое значение
    Point temp = *this;

    // вызываем префиксный инкремент
    ++(*this);

    // возвращаем копию до изменения
    return temp;
}
Теперь мы можем уже использовать как постфиксный и префиксный оператор инкремента.
cpp
Point p(1, 1);
Point q = p++; // q = (1,1), p = (2,2)
Point r = ++p; // r = (3,3), p = (3,3)
Оператор [] полезен, например, в классе, имитирующем массив:
cpp
class MyArray {
    int data[10];
public:
    int& operator[](int index) {
        return data[index];
    }
};

MyArray arr;
arr[0] = 42; // работает как обычный массив!
Что нельзя делать?
- Нельзя менять приоритет или количество операндов оператора.
- Нельзя создавать новые операторы (например, ***).
- Нельзя перегружать операторы для встроенных типов (например, int + int изменить нельзя).
- Перегрузка должна быть логичной: + должен складывать, а не вычитать.
§8.10.2 Перегрузка операторов в C#
В языке C# перегрузка операторов позволяет программисту определять, как стандартные операторы, такие как_ +, -, ==, !=_, будут работать с объектами пользовательских типов.
Это делает код более естественным и читаемым. Например, если у нас есть класс Vector, представляющий вектор на плоскости, мы можем написать:
csharp
Vector v1 = new Vector(1, 2);
Vector v2 = new Vector(3, 4);

Vector v3 = v1 + v2;  // Складываем векторы!
Такой код будет работать, только если мы перегрузим оператор +. В C# это делается иначе, чем в C++, и с более строгими правилами.
В C# перегрузка операторов осуществляется с помощью статических методов, объявленных внутри класса с ключевым словом operator. При этом нельзя использовать внешние функции — всё должно быть внутри самого класса.
csharp
public class Vector
{
    public double X { get; }
    public double Y { get; }

    public Vector(double x, double y)
    {
        X = x;
        Y = y;
    }

    // Перегрузка оператора +
    public static Vector operator+(Vector a, Vector b)
    {
        return new Vector(a.X + b.X, a.Y + b.Y);
    }
}
Теперь можно складывать объекты:
csharp
Vector v1 = new Vector(1, 2);
Vector v2 = new Vector(3, 4);

Vector v3 = v1 + v2;  // Работает!
Обратите внимание:
- Метод operator+ — статический.
- Он принимает два параметра — левый и правый операнды.
- Возвращает новый объект.
В C# разрешено перегружать следующие операторы:
- Унарные: +, -, !, ~, ++, --, true, false.
- Бинарные арифметические: +, -, *, /, %.
- Операторы сравнения: ==, !=, <, >, <=, >=.
- Логические: &, |, ^.
- Операторы сдвига: <<, >>.
Но есть ограничения:
- Нельзя перегружать операторы ., ::, ?:, sizeof, new, typeof — как и в C++.
- Операторы сравнения нужно переопределять парами: если есть ==, обязательно должен быть !=, и наоборот.
- Перегруженные операторы должны быть public и static.
- Один из параметров должен быть того же типа, что и класс, в котором оператор объявлен.
Часто нужно сравнивать объекты по значению, а не по ссылке. Для этого перегружают == и !=:
csharp
public static bool operator==(Vector a, Vector b)
{
    if (ReferenceEquals(a, b))
       return true;

    if (a is null || b is null)
        return false;

    return a.X == b.X && a.Y == b.Y;
}

public static bool operator!=(Vector a, Vector b)
{
    return !(a == b);
}
Теперь можно писать:
csharp
Vector v1 = new Vector(1, 2);
Vector v2 = new Vector(1, 2);

Console.WriteLine(v1 == v2); // True
Без перегрузки этот код вернул бы False, потому что по умолчанию == сравнивает ссылки, а не содержимое.
Операторы ++ и -- тоже можно перегружать. Как и в C++, они бывают префиксными и постфиксными. Различаются они только сигнатурой — постфиксная версия принимает фиктивный параметр int:
csharp
public static Vector operator++(Vector v)
{
    return new Vector(v.X + 1, v.Y + 1); // префикс
}

// Постфикс: фиктивный int, чтобы отличить от префиксного
public static Vector operator++(Vector v, int dummy)
{
    Vector result = new Vector(v.X, v.Y);
    v = v + new Vector(1, 1);

    return result;
}
На практике постфиксная версия редко используется в C#, потому что объекты часто неизменяемые.
C# позволяет определять, как объект класса преобразуется в другой тип. Например, можно сделать, чтобы Vector автоматически превращался в Point:
csharp
public static implicit operator Point(Vector v)
{
    return new Point((int)v.X, (int)v.Y);
}

// Использование:
Vector v = new Vector(5.5, 3.2);
Point p = v; // неявное преобразование
Слово implicit — неявное (автоматически), explicit — явное (требует (Point)v).
§8.11 Принцип ООП: «Наследование»
Одним из ключевых принципов объектно-ориентированного программирования является наследование.
Наследование
— механизм, позволяющий одному классу наследовать свойства и поведение другого.
Это означает, что новый класс, называемый производным или подклассом, может расширять и модифицировать функциональность уже существующего класса — базового или родительского. Наследование способствует повторному использованию кода, уменьшает дублирование и помогает строить иерархии типов, отражающие реальные взаимосвязи между объектами.
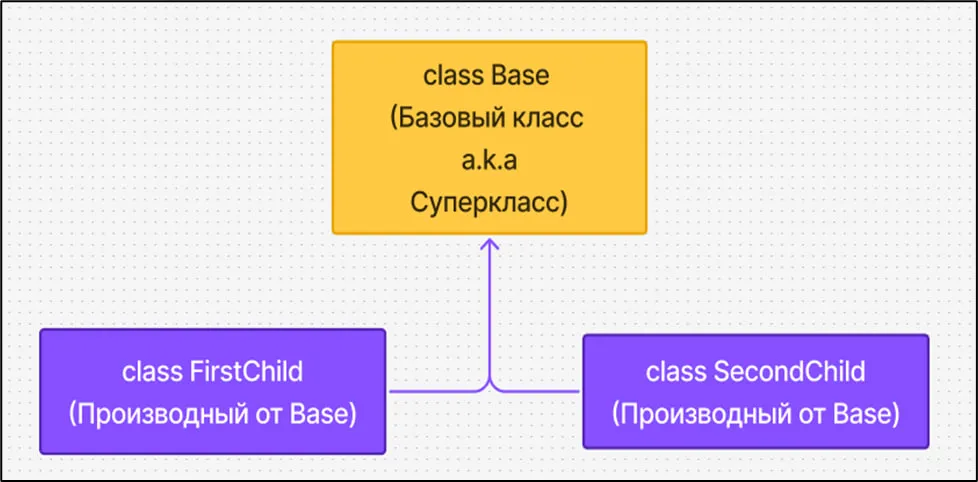
На рисунке приведена схема наследования между базовым классом (base class) и происходящими от него производными классами (child class).
Наследование позволяет производному классу наследовать свойства и методы другого класса. Это дает возможность создавать абсолютно новые классы путем абстрагирования общих атрибутов и поведений.
Одна из основных задач проектирования при объектно-ориентированном программировании заключается в выделении общности разнообразных классов.
Допустим, у вас есть класс Dog и класс Cat, каждый из которых будет содержать атрибут eyeColor. При процедурной модели код как для Dog, так и для Cat включал бы этот атрибут.
При объектно-ориентированном проектировании атрибут, связанный с цветом, можно перенести в класс с именем Mammal наряду со всеми прочими общими атрибутами и методами. В данном случае оба класса – Dog и Cat – будут наследовать от класса Mammal, как показано на рисунке ниже.
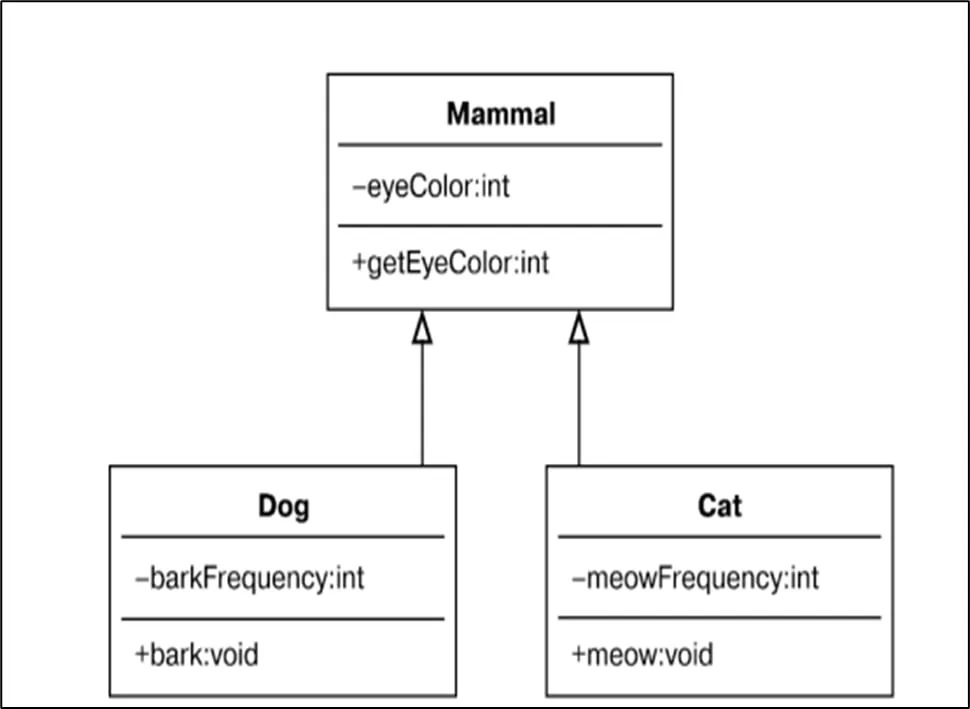
Итак, оба класса наследуют от Mammal. Это означает, что в итоге класс Dog будет содержать следующие атрибуты:
text
eyeColor //унаследован от Mammal
barkFrequency //определен только для Dog
В том же духе объект Cat будет содержать следующие методы:
text
getEyeColor //унаследован от Mammal
meow //определен только для Dog
Создаваемые экземпляр объекта Dog или Cat будет содержать все, что есть в его собственном классе, а также все имеющиеся в родительском классе.
Таким образом, Dog будет включать все свойства своего определения класса, а также свойства, унаследованные от класса Mammal.
§8.11.1 Наследование в С++
Наследование в C++
— это механизм, позволяющий одному классу, называемому производным или наследником, получать поля и методы другого класса — базового.
Это один из ключевых инструментов повторного использования кода и построения иерархий типов. Благодаря наследованию можно определить общее поведение в базовом классе и расширить или изменить его в производных, адаптируя функциональность под конкретные задачи.
Синтаксически наследование в C++ выражается через указание имени базового класса после двоеточия в объявлении производного класса:
cpp
class Derived : public Base {
    // новые поля и методы
};
Здесь ключевое слово public — это модификатор доступа при наследовании, и он определяет, как члены базового класса будут видны в производном.
В C++ существует три вида наследования:
- public — члены базового класса сохраняют свой уровень доступа: public остаётся public, protected — protected. Это наиболее распространённый и рекомендуемый способ.
- protected — все public-члены базового класса становятся protected в производном.
- private — все члены базового класса становятся private, даже если они были public. После такого наследования базовый класс фактически скрыт.
Например:
cpp
class Base {
public:
    void greet() { std::cout << "Hello from Base\n"; }
};

class Derived : private Base {
    // greet() становится private
public:
    void callGreet() { greet(); } // можно вызывать внутри
};

// Derived d;
// Ошибка: greet() — private из-за private-наследования
// d.greet();
Хотя все три вида допустимы, public-наследование используется по умолчанию при моделировании отношения «является» (is-a), например: «программист — это сотрудник». Остальные виды — редки и применяются в особых случаях, например, для композиции через наследование.
Для примера возьмем иерархию фигур. Рассмотрим базовый класс Shape:
cpp
class Shape {
protected:
    double x, y;
public:
    Shape(double x, double y)
        : x(x), y(y) {}

    // чисто виртуальный метод
    virtual void draw() const = 0;
};
Производный класс Circle:
cpp
class Circle : public Shape {
    double radius;
public:
    Circle(double x, double y, double r) : Shape(x, y), radius(r) {}

    void draw() const override {
        std::cout << "Рисуем круг в (" << x << ", " << y << ") с радиусом " << radius << "\n";
    }
};
Здесь Circle наследует положение (x, y) от Shape и добавляет своё поле radius. Метод draw() переопределяется с помощью механизма виртуальных функций, что позволяет реализовать полиморфизм: указатель на Shape может ссылаться на объект Circle, и будет вызван правильный метод.
Одной из особенностей C++ является поддержка множественного наследования — производный класс может наследовать от нескольких базовых классов:
cpp
class A
{
    public: void foo()
    {
        std::cout << "A\n";
    }
};

class B
{
    public: void bar()
    {
        std::cout << "B\n";
    }
};

class C : public A, public B {
    // имеет доступ к foo() и bar()
};
Это мощная возможность, но она может привести к алмазной проблеме наследования, когда два класса наследуют от одного и того же базового класса, а третий — от обоих:
cpp
class Base {
public: void greet() {
   std::cout << "Hello\n"; }
};

class D1 : public Base {};
class D2 : public Base {};

class Final : public D1, public D2 {};// два экземпляра Base!
Теперь объект Final содержит два независимых экземпляра класса Base, и вызов obj.greet() будет неоднозначен — из какого Base вызывать? Это и есть «алмазная проблема», потому что иерархия напоминает ромб (алмаз).
Решение — виртуальное наследование:
cpp
class D1 : virtual public Base {};
class D2 : virtual public Base {};

// теперь один экземпляр Base
class Final : public D1, public D2 {};
Ключевое слово virtual указывает, что базовый класс должен быть включён в иерархию только один раз. Теперь Base становится общим предком, и конфликт устраняется. Однако при этом конструктор Base должен быть вызван явно в конструкторе самого нижнего класса (Final), даже если он не участвует напрямую.
Не все члены базового класса автоматически передаются производному:
- Конструкторы — не наследуются, но могут быть вызваны через список инициализации.
- Деструкторы — не наследуются напрямую, но если деструктор базового класса объявлен как virtual, это обеспечивает корректный вызов при удалении через базовый указатель.
- Оператор присваивания — не наследуется, но может быть вызван явно: Base::operator=(other).
- Дружественные функции — не наследуются. Если в базовом классе есть friend, он имеет доступ к Base, но не получает автоматически доступ к Derived, если не объявлен там отдельно. Например:
cpp
class Base {
    int value;
    friend void helper(Base& b); // друг для Base
};

class Derived : public Base {
    int extra;
};

void helper(Base& b) {
    // b.value = 10; // OK
    // Ошибка: не имеет доступа к extra!
    // static_cast<Derived&>(b).extra = 5;
}
Чтобы helper имел доступ к Derived, нужно объявить его дружественным и там:
cpp
class Derived : public Base {
    // или лучше — void helper(Derived&);
    friend void helper(Base&);
    int extra;
};
§8.11.2 Наследование в С#
Наследование в C# позволяет одному классу — производному — наследовать поля, методы, свойства и события от другого класса — базового.
Это ключевой механизм повторного использования кода и реализации принципа «является» (is-a) в объектно-ориентированном программировании.
Например, класс Dog может наследовать от класса Animal, выражая утверждение: «Собака — это животное». Однако, в отличие от C++, наследование в C# имеет ряд важных ограничений, направленных на упрощение модели и повышение безопасности кода.
Одно из главных ограничений C# — отсутствие множественного наследования классов. Класс в C# может наследовать только от одного базового класса. Это упрощает иерархию типов и исключает такие проблемы, как алмазное наследование, известное по C++. Например, следующий код недопустим:
csharp
class Mammal { }
class Pet { }

// ❌ Ошибка: множественное наследование запрещено
class Dog : Mammal, Pet { }
Такое ограничение не означает, что объект не может реализовывать несколько поведений. Для этого в C# предусмотрены интерфейсы, которые позволяют классу наследовать контракты от нескольких источников:
csharp
interface IMammal { void GiveBirth(); }
interface IPet { void BeFriendly(); }

class Dog : Mammal, IMammal, IPet
{
    public void GiveBirth() { /* ... */ }
    public void BeFriendly() { /* ... */ }
}
Таким образом, C# заменяет множественное наследование множественной реализацией интерфейсов, что решает проблему композиции поведения без риска неоднозначности.
В C# можно запретить наследование от класса с помощью модификатора sealed — «запечатанный». Если класс объявлен как sealed, от него нельзя наследовать. Это полезно, когда класс содержит критически важную логику, которую нельзя изменять, или когда он предназначен для завершённой функциональности.
csharp
sealed class FinalClass
{
    public void DoWork()
    {
        Console.WriteLine("Работа выполнена");
    }
}

// ❌ Ошибка: нельзя наследовать от sealed-класса
// class Derived : FinalClass { }
Попытка наследовать от FinalClass приведёт к ошибке компиляции. Модификатор sealed можно также применять к отдельным методам в производных классах, если они переопределяют виртуальные методы базового класса.
Если класс, наоборот, предназначен только для наследования, он может быть объявлен как abstract. Такой класс нельзя создавать напрямую с помощью new, но от него можно наследовать. Он может содержать как реализованные методы, так и абстрактные — без тела, которые обязательно должны быть переопределены в производных классах.
csharp
abstract class Shape
{
    // нет реализации — должен быть переопределён
    public abstract void Draw();

    public void Move(int dx, int dy)
    {
        Console.WriteLine($"Перемещено на ({dx}, {dy})");
    }
}

class Circle : Shape
{
    public override void Draw()
    {
        Console.WriteLine("Рисуем круг");
    }
}
Здесь Shape — абстрактный класс. Создать new Shape() нельзя, но можно new Circle(). Метод Draw() обязан быть реализован в Circle, иначе — ошибка компиляции.
В C# для переопределения виртуального метода базового класса используется ключевое слово override. Базовый метод должен быть помечен как virtual, abstract или override.
csharp
class Animal
{
    public virtual void Speak()
    {
        Console.WriteLine("Животное издаёт звук");
    }
}

class Dog : Animal
{
    public override void Speak()
    {
        Console.WriteLine("Гав-гав!");
    }
}
Если в производном классе нужно запретить дальнейшее переопределение, используется sealed override:
csharp
class Puppy : Dog
{
    public sealed override void Speak()
    {
        Console.WriteLine("Тяф-тяф!");
    }
}
Теперь любой класс, унаследованный от Puppy, не сможет переопределить Speak().
При создании объекта производного класса сначала вызывается конструктор базового класса. Это обеспечивается с помощью base():
csharp
class Person
{
    public string Name { get; }

    public Person(string name) => Name = name;
}

class Student : Person
{
    public int Id { get; }

    public Student(int id, string name) : base(name)
    {
        Id = id;
    }
}
Здесь base(name) передаёт имя в конструктор Person, обеспечивая корректную инициализацию базовой части объекта.